ネットワークオペレーションセンター(NOC)とは:日々の業務、シフトの流れ、引き継ぎメモのひな形
ネットワークオペレーションセンター(NOC)が毎日行うこと。監視範囲、シフトの流れ、アラート対応、引き継ぎメモのひな形、NOCとSOCの違いを解説します。
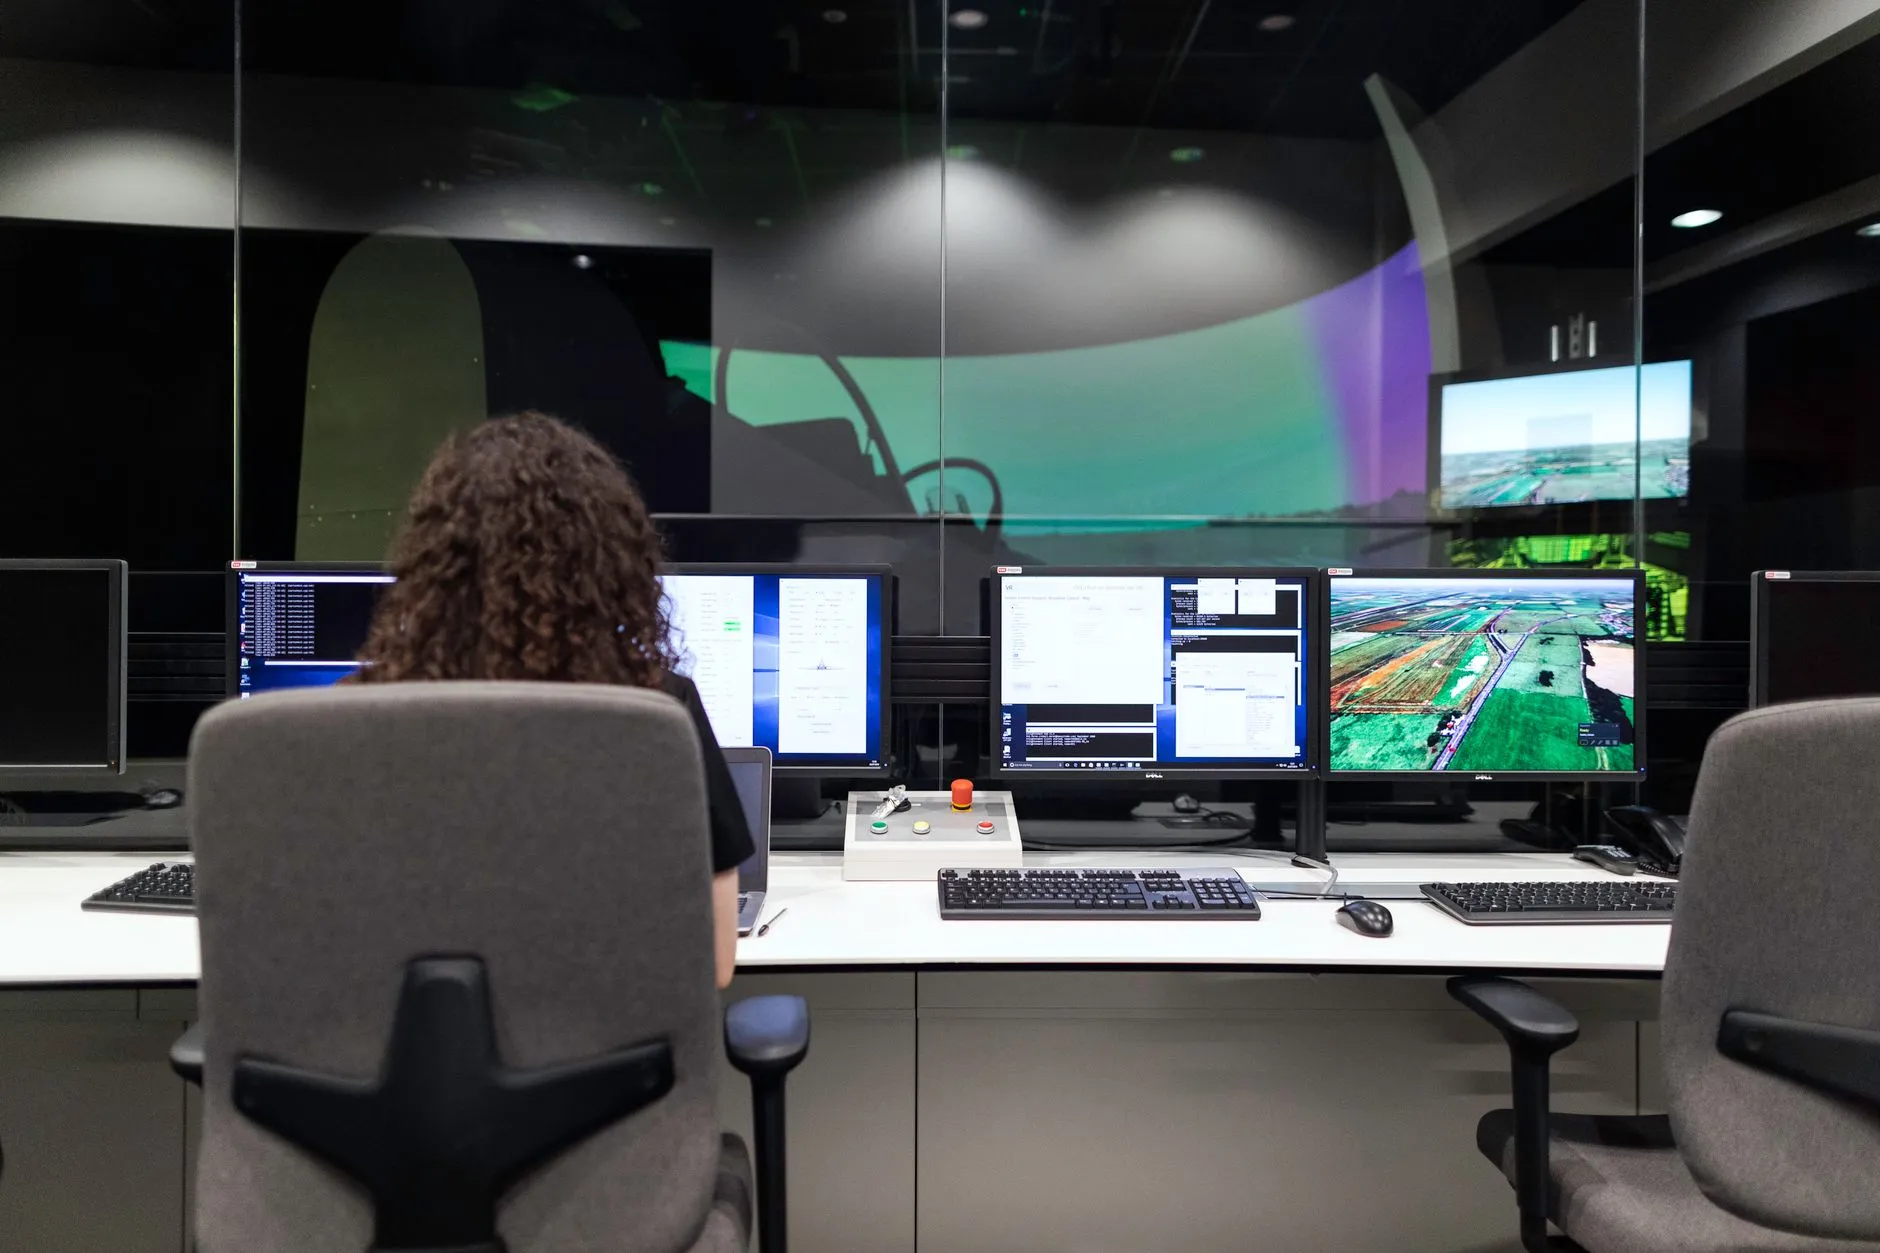
要点:NOC(ネットワークオペレーションセンター)は、取り決めた時間帯にネットワークとインフラを見守り、障害を検知し、対処またはエスカレーションし、記録を残すチームとツールのことです。NOCが守るのは可用性と性能で、SOC(セキュリティオペレーションセンター)が守るのは攻撃からの安全です。両方が1つの組織に存在することもあり、その間の受け渡しの経路を明確にしておく必要があります。
この記事は、NOCが必要かどうかを検討している情シス担当者と、委託先のNOCサービスを評価する方向けです。NOCが何を監視するか、シフトがどう進むか、引き継ぎメモのひな形、エスカレーション条件の出発点、NOCとSOCの違いを説明します。
NOCとは何か
ウィキペディアの「Network operations center」の記事(2026年10月28日に確認)では、NOCを次のように説明しています。コンピューター、通信、衛星ネットワークに対するネットワークの監視と制御を行う、1つまたは複数の拠点です。NOCのエンジニアは、ネットワーク障害、停電、可用性に影響する攻撃に対応します。ファイアウォールやルーターなどの機器を設定し、稼働状況を監視して、中核のネットワークを安定させます。多くは交代制で勤務します。
中小企業にとってのNOCは、多くの場合サービスを指します。委託先のチーム、ツール、手順が、ネットワークとサーバーを監視し、アラートに対応し、エンジニアへエスカレーションします。大型モニターのある部屋は必要ありません。必要なのは、カバーする時間帯、明確な範囲、そして深夜2時でも回る手順です。
NOCは毎日何をするのか
- ネットワーク機器、インターネット回線、サーバー、重要なサービス、バックアップの状態を監視する。
- アラートを仕分ける:本当の障害か、ノイズか、今すぐ対応が必要かを判断する。
- リモートで直せるものを切り分けて対処する:サービスの再起動、回線の切り替え、固まったインターフェースの復旧、承認済みの手順に沿った設定変更。
- 上位のレベル、ベンダー、現地対応が必要な障害を、明確な引き継ぎとともにエスカレーションする。L1・L2・L3サポートを参照。
- 影響を受ける利用者とサービス責任者に、取り決めた間隔で連絡する。
- すべてのアラート、対応、結果をチケットに記録し、履歴を検索できるようにする。
- 計画作業を扱う:保守時間帯、変更の前後の確認、キャパシティの観察。
- 可用性、インシデント、傾向を報告する。
NOCは何を監視するのか
範囲は文書で合意しておきます。典型的な範囲の一覧です。
- ネットワーク機器:ファイアウォール、ルーター、スイッチ、無線コントローラーとアクセスポイント、VPNゲートウェイ。可用性、インターフェースの状態、使用率、エラー。
- インターネット回線とWAN回線:稼働状態、遅延、パケットロス、切り替えの状態。
- サーバーと仮想ホスト:稼働状態、CPU、メモリ、ディスク、重要なサービス。
- 基盤サービス:DNS、DHCP、ディレクトリサービス、時刻同期。
- バックアップジョブ:成否、最後に成功したバックアップの経過時間。
- 電源と環境:UPSの状態、センサーがあれば室温。
- クラウドとアプリの確認:Webサイトやログインページの応答、メールフロー、Microsoft 365のサービス正常性(Microsoft 365 admin center > Health > Service health)。
- 有効期限:証明書、ドメイン、保守契約。
しきい値の出発点は、何を監視し、アラートのしきい値をどこから始めるかをお読みください。
そのまま使えるシフトの流れ
時刻は自社のカバー時間に合わせて調整してください。
シフトの開始時
- 前のシフトの引き継ぎメモを読む(ひな形は下記)。
- 未完了のチケットと、ベンダーや利用者の返答待ちの案件を確認する。
- 監視ツール自体を確認する。すべてのコレクターとエージェントが報告しているか。
- 本日の計画保守と変更カレンダーを確認する。
シフト中
- アラートを優先度順に処理する。1件ずつ受付(acknowledge)し、対応中であることが全員に分かるようにする。
- アラートごとに、誤検知(後で調整)、記録すべきイベント、対応すべきインシデントのいずれかを判断する。
- インシデントは取り決めたルールで優先度を付ける。重大度と優先度の違いを参照。
- 対応したその場でチケットを更新する。後から記憶で書かない。
- 下のトリガーに当てはまれば、確証を待たずにエスカレーションする。
- 計画された変更の前後に、影響を受ける機器とその周辺機器を確認する。
毎時、または決めた間隔で
- ダッシュボードで、赤に向かって悪化している黄色の項目を確認する。
- その間のバックアップとジョブの状態を確認する。
- 未完了のインシデントについて、取り決めた経過報告を送る。
シフトの終了時
- 完了したものを、原因と対処の短い要約とともにクローズする。
- 引き継ぎメモを書く。
- 重大なものは、メッセージや電話で口頭でも引き継ぐ。進行中のインシデントはメモだけでは足りない。
引き継ぎメモのひな形
チケットツールや共有ドキュメントにコピーして使います。各行は短く書きます。
- シフトと記入者:日付、時間帯、書いた人、受け取る人。
- 未解決のインシデント:チケット番号、症状を一言で、優先度、現在の状況、次の対応、次の更新予定。
- 注視中のアラート:何か、なぜまだインシデントではないのか、エスカレーションする条件。
- 計画作業:次のシフト中の保守時間帯と変更。承認者とロールバック計画を添える。
- 他者の返答待ち:ベンダーのケース番号、利用者の返信、部品。誰がいつ催促するか。
- このシフトで行った変更:何を、どの機器で、誰の承認で変更したか。
- 既知の問題と回避策:書かなければ次のシフトがまた調べ直すことになるもの。
- 監視自体の状態:ツールやコレクターの問題、ミュートしたアラートとその解除時刻。
- 使用中の連絡先:当番エンジニア、ベンダーの窓口、未解決案件の顧客側窓口。
- 次のシフトが知っておくべきこと:各1行で。
エスカレーション条件の出発点
以下は調整を前提とした出発点で、標準ではありません。SLAとエスカレーションマトリクスに結びつけてください。ITエスカレーションマトリクスのひな形を参照。
- 時間:インシデントに5分経っても担当者がいない、または重大なものが30分経っても進展がない。
- 影響:複数の拠点や部門に影響がある、または基盤サービス(インターネット、認証、メール)が停止している。
- リスク:攻撃、データ損失、想定外の設定変更の兆候があれば、直ちにセキュリティ担当へ。
- スキル:その障害に対応する文書化された手順がNOCにない。
- ベンダー:メーカーの対応が必要なハードウェア故障や不具合。
- 重大インシデント:重大インシデントの基準に該当する場合は、重大インシデント管理の手順に切り替える。
NOCとSOCの違い
ウィキペディアの「Security operations center」の記事(2026年10月28日に確認)によると、SOCは組織のネットワークを監視し、潜在的なセキュリティインシデントを調査し、脅威を取り除くために必要な措置を講じます。SOCは社内のチームでも、外部のセキュリティサービス事業者が運営するものでもよいとも記されています。実務上の違いは次のとおりです。
主な問い:NOCは「動いているか、性能は出ているか」を問います。SOCは「安全か、誰かが攻撃していないか」を問います。
典型的なアラート:NOCはリンクダウン、使用率の高騰、バックアップ失敗、サービス停止を扱います。SOCは不審なサインイン、マルウェアの検知、異常なデータの動き、セキュリティツールからのアラートを扱います。
典型的な対応:NOCは再起動、切り替え、再設定、エンジニアの派遣を行います。SOCは端末の隔離、アカウントの遮断、調査、さらなる活動の追跡を行います。
専門スキル:NOCにはネットワークとインフラのスキルが必要です。SOCにはセキュリティ分析とインシデント対応のスキルが必要です。
接点:障害が攻撃だったり、攻撃が障害に見えたりします。双方のチームがどう案件を受け渡すかを決めておきます。当社のセキュリティ監視についてはセキュリティオペレーションセンターをご覧ください。
NOCサービスの良し悪しをどう見分けるか
- 文書化された範囲:監視対象システムの一覧と、それぞれに対する確認内容。
- カバー時間:営業時間か24時間か、時間外はどうなるか。
- 対応目標:優先度別の初動の目標。当社はSLAのページで公開しており、どの委託先も公開しているべきです。
- エスカレーション経路:誰に、どの順で、いつまでに連絡するか。
- レポート:可用性、インシデント、アラート件数、平均確認時間と平均復旧時間。MTTA・MTTR・MTBFを参照。
- 変更管理:誰が何を変更でき、変更をどう承認し記録するか。
- 引き継ぎの質:個人情報などを伏せた引き継ぎメモの例を見せてもらう。
よくある失敗
- 機器だけを見て、サービスを見ない。機器はすべて稼働しているのに、利用者は仕事ができない。サービスとログインの確認を加えます。
- 共通の範囲がない。プリンター、VPN、Wi-Fiが対象かどうか、誰も分からない。文書にします。
- アラート疲れ。価値の低いアラートが多いと、本物が埋もれます。毎月アラート件数を見直します。
- 記憶に頼った引き継ぎ。口頭だけでは細部が落ちます。ひな形を使います。
- 直したのに記録しない。対応がチケットに残っていないと、繰り返されたり矛盾したりします。
- セキュリティ担当への経路がない。攻撃の疑いは、ネットワーク障害の一つではなく、セキュリティ案件として扱います。
- 誰も見ていない監視。沈黙したコレクターは、静かなネットワークに見えます。
動作確認の方法
- 監視対象の機器を1台選び、保守時間帯に停止させる。アラート、受付、チケット化が目標時間内に行われることを確認する。
- 直近3件の引き継ぎメモを読む。初めて見る人がそれだけでシフトを始められるか。
- 先月のすべてのインシデントに、原因、対処、担当者が記録されているか確認する。
- アラート件数とインシデント件数を比べる。差が大きければ、調整が遅れている。
- ベンダーやセキュリティ担当へのエスカレーションを1回練習し、連絡先が実際に通じることを確かめる。
よくある質問
ネットワークオペレーションセンターは何をするところですか?
ネットワークとインフラを監視し、アラートを仕分け、障害を対処またはエスカレーションし、影響を受ける利用者に連絡し、計画保守を扱い、すべてをチケットに記録します。
NOCとSOCの違いは何ですか?
NOCはシステムの可用性と性能を保ち、SOCはセキュリティ上の脅威を検知して対応します。データを共有し、取り決めた受け渡しの経路が必要です。
NOCの役割は何ですか?
問題を早く見つけ、サービスを速やかに復旧し、繰り返す障害から学ぶことで、サービスを動かし続けることです。アラートがチケットになり、チケットが適切なエンジニアに届く中心点として機能します。日々の業務は、監視、アラートの仕分け、インシデント対応とエスカレーション、変更の確認、連絡、引き継ぎ、可用性と傾向の報告です。
NOCを運営するには何が必要ですか?
定義された範囲、監視とチケットのツール、カバー時間に合わせたシフトで働く訓練済みの要員、文書化された手順、エスカレーションマトリクス、引き継ぎと報告の定型運用です。小さな組織は自前で作るより、サービスとして購入するのが一般的です。
次のステップ
この運用をチームに任せたい場合は、まずBrocent オペレーションセンターのページをご覧ください。
2026年10月28日に確認した情報源:ウィキペディア「Network operations center」と「Security operations center」。しきい値は出発点の例で、調整が必要です。
Brocent は香港・シンガポール・中国本土・米国向けのマネージドITサポートのプランとユーザー単価の月額料金を公開しているため、問い合わせ前に比較できます。プランと料金を見る。
共有:
今すぐ行動を
インサイトをビジネスのITロードマップへ。
APACのITエキスパートと15分間の無料相談をご予約ください。現在の環境を確認し、24時間以内にカスタマイズされたITロードマップを提供します。
すべてのサービスを見る無料チェックリスト
中国大陸へのIT展開前に確認すべき10の重要事項
PIPL準拠、ネットワーク分割、バイリンガルヘルプデスクの設定など、中国での初日に必要なすべてのIT準備。
チェックリストを申請 →📬 アジアIT月報
中国コンプライアンス情報、サイバーセキュリティ警報、APACチーム向けITのヒントを毎月お届けします。
スパムなし。いつでも配信停止できます。


